

凌晨四點,多數人還沉浸於夢鄉之中,儘管未到破曉之時,相信已經有許多人悄悄睜開雙眼,享受這靜謐的城市。
凌晨四點,或許派大星剛享用完他的美味蟹堡,或許哲哲正為他的粉絲寫著解盤文章,或許已經有人開始準備為一整天的生活打拼,也或許有人正等著他的另一半來他家煮一碗熱騰騰的牛肉麵,開啟一個美好的早晨。
但我相信,什麼都比不上凌晨四點請女友帶著 GPU 來我家,一起鑽研 Kubernetes 與 GPU 到底能產生什麼樣的化學反應。
嗯廢話有點多,所以為什麼會有這個系列呢?簡而言之,前陣子 Kubernetes v1.34 發布後 DRA 正式進入 GA,稍微玩了一下覺得這東西蠻酷的,至於什麼是 DRA 呢?想像一下在 K8s 上你的 Pod 能用類似 PV & PVC 的方式對 GPU 提交更彈性的申請,而不是以往的全有或全無,大概就是這樣,細節之後再說。
有了 DRA 後,那就更不能錯過 Kubernetes 與 AI Infra 的愛恨交織了,我作為一名 data engineer 應該對大部分 K8s 的觀念算是蠻熟悉的,但要牽扯到一些 LLM 相關的知識及原理就有一點力不從心了,於是就趁著這次鐵人賽的機會來自主研究一下 K8s 上的 AI Infra。
未來三十天的內容主要會去了解一些 LLM 相關觀念及技術名詞,並且實際去看這些技術是如何部署在 Kubernetes 上,以及 Kubernetes 原生提供了哪些 API resource 來解決哪些痛點。應該是沒辦法做到那種系統式的教學,整體比較會偏向是我自己的個人筆記,而且會蠻仰賴 AI 的知識,所以如果有寫錯的話再麻煩指正。
CNCF 在 2026 年一月發布了 2025 年度雲原生調查,以《The Infrastructure of AI's Future》為主題,對 628 位受訪者進行調查。
在有 AI 工作負載的組織中,66% 已經在 Kubernetes 上運行生成式 AI 工作負載。其中 23% 在推論工作負載上完全採用 Kubernetes,這些團隊可能已對模型部署導入 GitOps 工作流程、透過 Prometheus 與 Grafana 為模型效能指標建立穩固的監控機制,並將 AI 工作負載整合進既有的 CI/CD 流水線。另外 43% 則是部分採用,往往從批次推論或開發/測試環境切入,正式環境的服務仍維持既有的舊系統。
另有 18% 表示打算導入 Kubernetes,尚未動手的原因可能是既有 ML 平台的投資、對維運複雜度的疑慮,以及團隊需要重新訓練。畢竟把 AI 工作負載搬上 Kubernetes 不只是容器化那麼簡單,還得確保模型落在具備 GPU 親和性、資源配置適當的節點上,並為訓練流水線與低延遲服務分別設計不同的架構模式。
在 98% 的組織都已採用雲原生的情況下,焦點早就從「要不要用」轉移到「怎麼把價值最大化」。值得注意的是,52% 的組織並不訓練模型,只是消費模型,有在做的也大多只是拿自己的資料微調。然而即便只是消費,AI 的野心與部署現實之間的落差依然懸殊,47% 的組織只是偶爾部署模型,能做到每日部署的僅有 7%。
因此,當模型不是自己訓練的,平台大家都跑 Kubernetes,誰能打造完美的 AI Infra 便能拉開差距,如同該報告的結尾:
As cloud native becomes boring infrastructure, the competitive advantage shifts to those who can build reliable, scalable, and sustainable systems on that foundation.
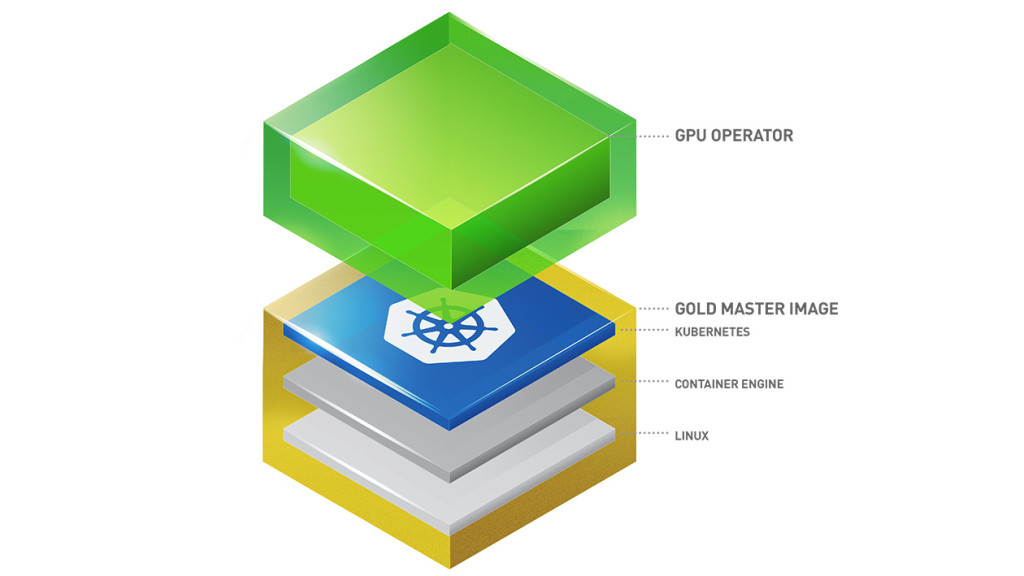
要讓 Kubernetes 用得到 GPU,光把卡插上去是不夠的。節點上得先有 NVIDIA driver 才跑得動 CUDA,要有 container runtime 才能把卡交進容器裡,要有 device plugin,kubelet 才認得到這張卡,還要有監控、要有節點標籤。這些東西一台一台手動裝,官方自己的說法是「difficult and prone to errors」。
GPU Operator 就是把這一整套自動化起來。它用 Kubernetes 的 operator framework 實作,一言以蔽之:「creates, configures, and manages GPUs in Kubernetes」。
它幫你管的東西包括:
| 元件 | 做什麼 |
|---|---|
| NVIDIA drivers | 讓節點跑得動 CUDA |
| NVIDIA Container Runtime | 把 GPU 交進容器裡 |
| Kubernetes device plugin | 讓 kubelet 認得到這張卡 |
| Automatic node labelling | 自動標出這台機器有什麼硬體 |
| DCGM-based monitoring | GPU 的指標監控 |
接下來三十天的實驗都會跑在 AWS EC2 上。考慮到經費限制,總共會啟動三台 EC2,其中一台沒有任何 GPU,會透過 Fake GPU Operator 在 Kubernetes API 層模擬 GPU 資源。另外兩台則各配置一張 NVIDIA L40S,用於單卡與雙節點情境的測試。
| 值 | |
|---|---|
| 執行個體 | m7i.2xlarge |
| GPU | 無 |
| vCPU / 記憶體 | 8 vCPU / 32 GB |
| 儲存 | 120 GB gp3 |
| 作業系統 | Ubuntu 26.04 LTS |
| 版本 | |
|---|---|
| Docker | 29.1.3 |
| kind | v0.32.0 |
| kubectl | v1.36.4 |
| helm | v4.2.4 |
# --- Docker ---
sudo apt-get update && sudo apt-get install -y docker.io
sudo usermod -aG docker "$USER"
newgrp docker

# --- kind ---
curl -Lo /tmp/kind https://kind.sigs.k8s.io/dl/v0.32.0/kind-linux-amd64
sudo install -m 755 /tmp/kind /usr/local/bin/kind

# --- kubectl ---
curl -Lo /tmp/kubectl https://dl.k8s.io/release/v1.36.4/bin/linux/amd64/kubectl
sudo install -m 755 /tmp/kubectl /usr/local/bin/kubectl

# --- helm ---
curl -fsSL https://raw.githubusercontent.com/helm/helm/main/scripts/get-helm-3 | bash
fake-gpu-cluster.yaml
kind: Cluster
apiVersion: kind.x-k8s.io/v1alpha4
name: gpu-lab

featureGates:
  DRADeviceTaintRules: true
  DRAListTypeAttributes: true
  DRAWorkloadResourceClaims: true
  DRANodeAllocatableResources: true
  GangScheduling: true
  GenericWorkload: true

kubeadmConfigPatches:
  - |
    kind: ClusterConfiguration
    apiServer:
      extraArgs:
        - name: runtime-config
          value: "resource.k8s.io/v1beta1=true,resource.k8s.io/v1beta2=true,scheduling.k8s.io/v1alpha2=true"

containerdConfigPatches:
  - |-
    [plugins."io.containerd.grpc.v1.cri"]
      enable_cdi = true

nodes:
  - role: control-plane
    image: kindest/node:v1.36.1@sha256:3489c7674813ba5d8b1a9977baea8a6e553784dab7b84759d1014dbd78f7ebd5
  - role: worker
    image: kindest/node:v1.36.1@sha256:3489c7674813ba5d8b1a9977baea8a6e553784dab7b84759d1014dbd78f7ebd5
  - role: worker
    image: kindest/node:v1.36.1@sha256:3489c7674813ba5d8b1a9977baea8a6e553784dab7b84759d1014dbd78f7ebd5
kind create cluster --config fake-gpu-cluster.yaml --wait 120s
# ① 只標一個 worker 有 GPU,另一個保持乾淨,「有卡/沒卡」才對照得出來
kubectl --context kind-gpu-lab label node gpu-lab-worker \
  run.ai/simulated-gpu-node-pool=default --overwrite

# ② 裝 Fake GPU Operator
helm upgrade -i gpu-operator \
  oci://ghcr.io/run-ai/fake-gpu-operator/fake-gpu-operator \
  --kube-context kind-gpu-lab --namespace gpu-operator --create-namespace \
  --version 0.2.0 \
  --set-string topology.nodePools.default.gpuProduct="NVIDIA-A100-SXM4-40GB" \
  --set topology.nodePools.default.gpuCount=8 \
  --set topology.nodePools.default.gpuMemory=40960 \
  --wait --timeout 5m
裝完後可以來驗證一下:
kubectl --context kind-gpu-lab get nodes \
  -o custom-columns=NODE:.metadata.name,GPU:.status.allocatable.'nvidia\.com/gpu'
這台機器上沒有任何 GPU,但 Kubernetes 現在認為 gpu-lab-worker 插著八張 A100
NODE                    GPU
gpu-lab-control-plane   <none>
gpu-lab-worker          8
gpu-lab-worker2         <none>
兩台規格完全相同,各一張 L40S。
| 值 | |
|---|---|
| 執行個體 | g6e.2xlarge |
| GPU | 1× NVIDIA L40S 48GB (allocatable 46068 MiB) |
| vCPU / 記憶體 | 8 vCPU / 64 GB |
| 儲存 | 200 GB gp3 |
| AMI | Deep Learning Base OSS Nvidia Driver GPU AMI (Ubuntu 22.04)(驅動預裝) |
下面步驟 0 兩台都要做,步驟 1 到 3 只在第一台,步驟 4 之後是第二台加入。
nvidia-smi -L
GPU 0: NVIDIA L40S (UUID: GPU-f01809ac-8e3a-c964-f3f5-7cbd204b658a)
curl -sfL https://get.k3s.io | sudo sh -s - \
  --write-kubeconfig-mode 644 \
  --disable traefik --disable servicelb \
  --default-runtime nvidia

export KUBECONFIG=/etc/rancher/k3s/k3s.yaml
curl -fsSL https://raw.githubusercontent.com/helm/helm/main/scripts/get-helm-3 | bash
在實體 GPU 的環境中,我們預設全部使用 DRA,並關閉 Device Plugin 的功能
helm upgrade --install gpu-operator \
  oci://nvcr.io/nvidia/cloud-native-charts/gpu-operator \
  --version v26.7.0 -n gpu-operator --create-namespace \
  --set driver.enabled=false \
  --set toolkit.enabled=false \
  --set gpuCluster.deployCR=true \
  --set clusterPolicy.deployCR=false \
  --set draDriver.featureGates.MPSSupport=true \
  --set draDriver.featureGates.TimeSlicingSettings=true \
  --wait --timeout 15m
確認 Pod 都 running
kubectl get pods -n gpu-operator
NAME                                                          READY   STATUS    RESTARTS   AGE
gpu-operator-6cd4764cbf-bwvr5                                 1/1     Running   0          38m
gpu-operator-node-feature-discovery-gc-7d4b864d68-6ch96       1/1     Running   0          38m
gpu-operator-node-feature-discovery-master-8649684bd6-lzcfv   1/1     Running   0          38m
gpu-operator-node-feature-discovery-worker-9ft75              1/1     Running   0          38m
nvidia-dcgm-exporter-dra-btcb7                                1/1     Running   0          37m
nvidia-dra-driver-controller-5499f7bdb-mq6bq                  1/1     Running   0          26m
nvidia-dra-driver-kubelet-plugin-s6hrt                        2/2     Running   0          26m
nvidia-dra-validator-t8g4w                                    1/1     Running   0          37m
sudo cat /var/lib/rancher/k3s/server/node-token
第二台不用裝 k3s server,也不用再裝一次 helm 與 GPU Operator,GPU Operator 是叢集層級的,它的 DaemonSet 會自動鋪到新加入的節點上。
curl -sfL https://get.k3s.io -o /tmp/k3s-install.sh
sudo env \
  K3S_URL=https://<第一台的 private IP>:6443 \
  K3S_TOKEN=<token> \
  sh /tmp/k3s-install.sh --default-runtime nvidia
kubectl get nodes -o wide
NAME              STATUS   ROLES           AGE     VERSION        INTERNAL-IP
ip-172-31-26-39   Ready    control-plane   6m19s   v1.36.4+k3s1   172.31.26.39
ip-172-31-30-5    Ready    <none>          58s     v1.36.4+k3s1   172.31.30.5
但節點 Ready 不代表卡被看見,真正的判準是兩張卡都出現在 ResourceSlice 裡:
kubectl get resourceslices -o wide
NAME                                                    NODE              DRIVER                      POOL
00000-compute-domain.nvidia.com-ip-172-31-26-39-gjkq9   ip-172-31-26-39   compute-domain.nvidia.com   ip-172-31-26-39
00000-compute-domain.nvidia.com-ip-172-31-30-5-xh29j    ip-172-31-30-5    compute-domain.nvidia.com   ip-172-31-30-5
00000-gpu.nvidia.com-ip-172-31-26-39-vlz4g              ip-172-31-26-39   gpu.nvidia.com              ip-172-31-26-39
00000-gpu.nvidia.com-ip-172-31-30-5-xgk8r               ip-172-31-30-5    gpu.nvidia.com              ip-172-31-30-5
今天把接下來三十天要用的東西準備好了:一台沒有 GPU 的機器,靠 Fake GPU Operator 讓 Kubernetes 相信它插著八張 A100;另外兩台各一張 L40S,組成一個真正的兩節點叢集。
明天將從最基本的問題開始:GPU 上到底在跑什麼?一個請求送進去之後,又發生了什麼事。
CNCF Annual Cloud Native Survey: The infrastructure of AI's future
[GitHub] Fake GPU Operator
[GitHub] GPU Operator
Building an AI factory on Kubernetes


 iThome鐵人賽
 看影片追技術